核心观点:采购决策中常见的失误,不是选错了算法模型,而是选错了一个只会讲模型的供应商。全栈AI方案的采购决策,本质上是选择未来三到五年内由谁来对系统效果负责。
制造企业的设备预测性维护、能源单位的调度优化、政务大厅的智能审批、高校实验室的科研数据治理——这四类场景有一个共同特征:AI方案不是单纯的软件部署,而是算法能力、硬件集成、系统集成与长期运维的复合体。采购决策中常见的失误,不是选错了算法模型,而是选错了一个只会讲模型的供应商。
我们在江苏省"人工智能+制造"诊断服务商资源池的工作实践中,积累了大量客户前期咨询的案例数据。以下五个问题,是决策者在供应商沟通环节最该追问、也最少被追问的内容。
第一问:你的能力边界从哪一层开始,到哪一层结束?
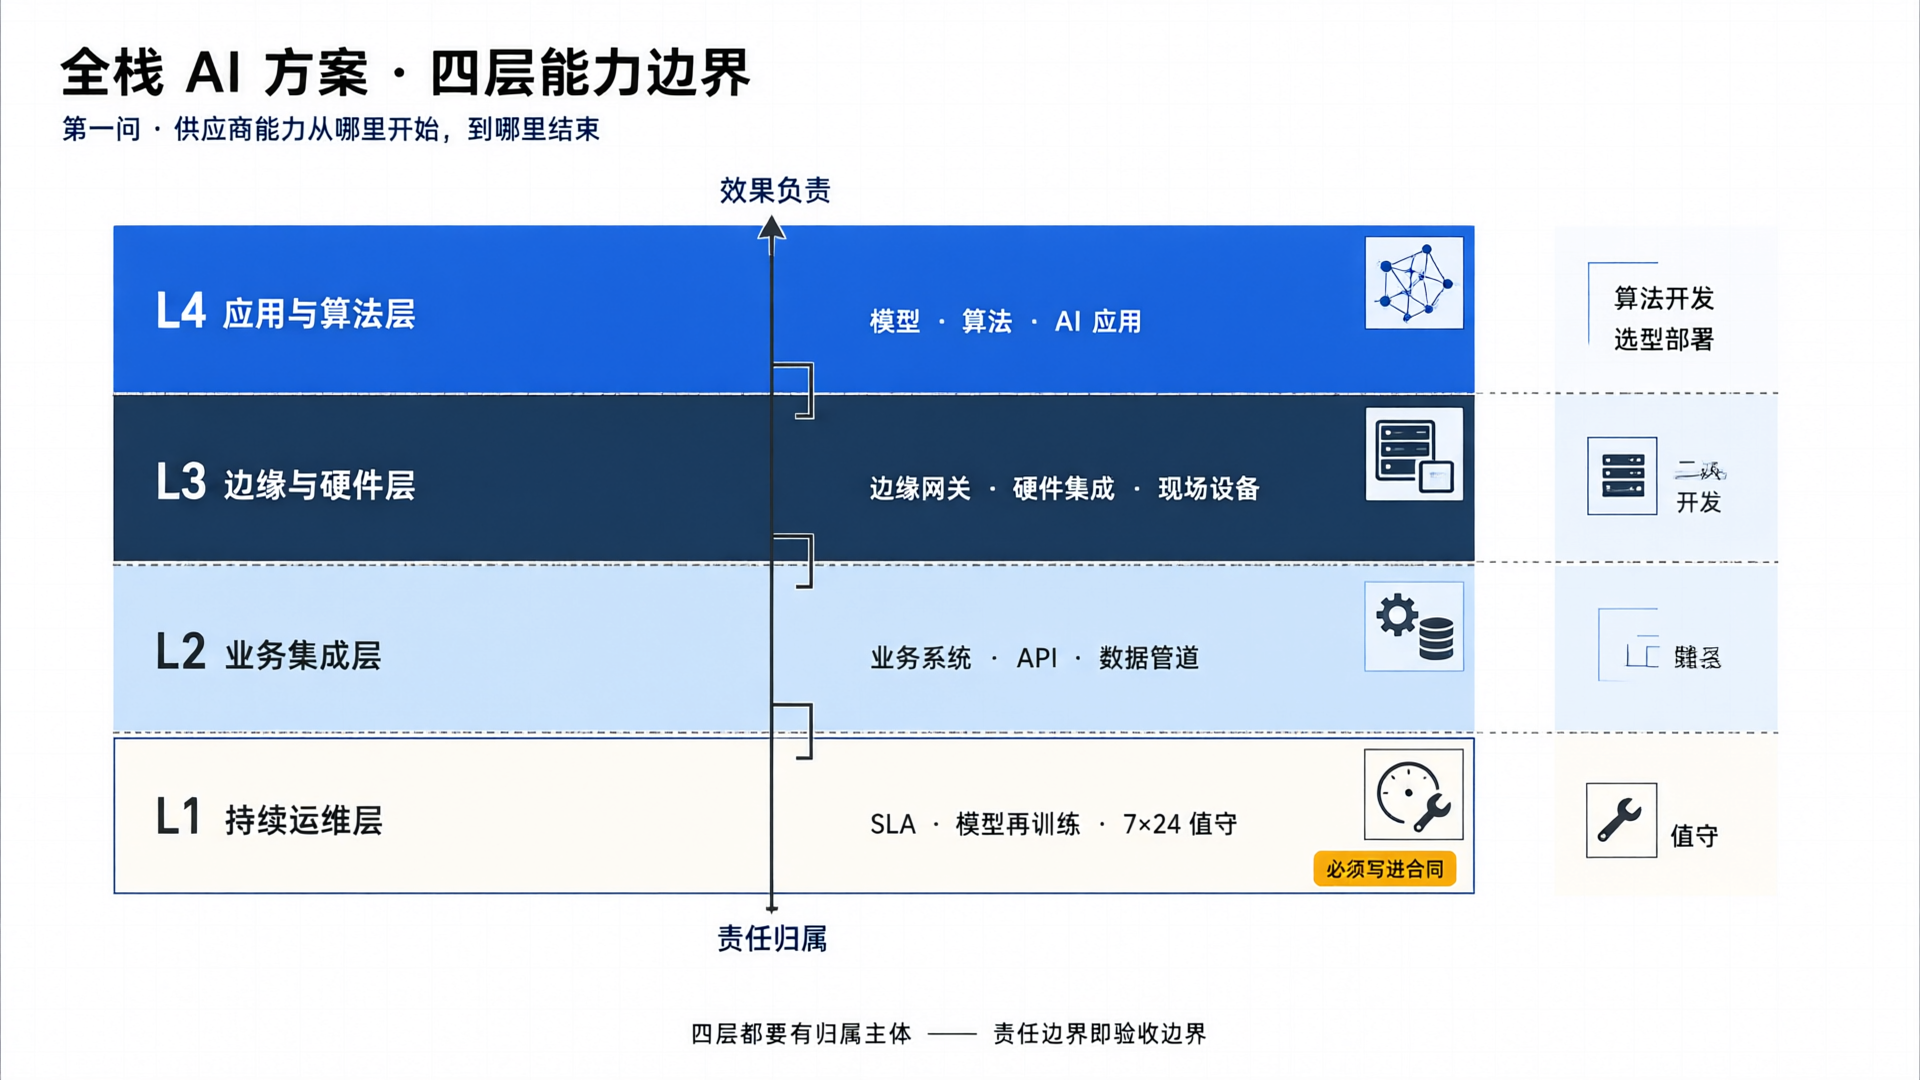
全栈AI方案涉及至少四个层面:模型与算法层、边缘计算与硬件层、业务系统集成层、持续运维层。多数供应商只在其中一到两层有实际交付能力,但标书中往往把整体方案写成"一站式"。
判断依据很直接——要求供应商提供覆盖全部四层的已验收项目清单(不是合作案例,是验收报告)。以策腾智能为例,我们的交付链条从AI算法开发延伸到智能硬件选型部署,再叠加7×24小时运维托管,四个层面有独立的交付团队和验收标准。
如果供应商无法说清楚每一层的责任归属主体,采购方需要自行补位的部分就是后续成本失控的起点。
第二问:进入实施前,是否有独立的诊断环节?
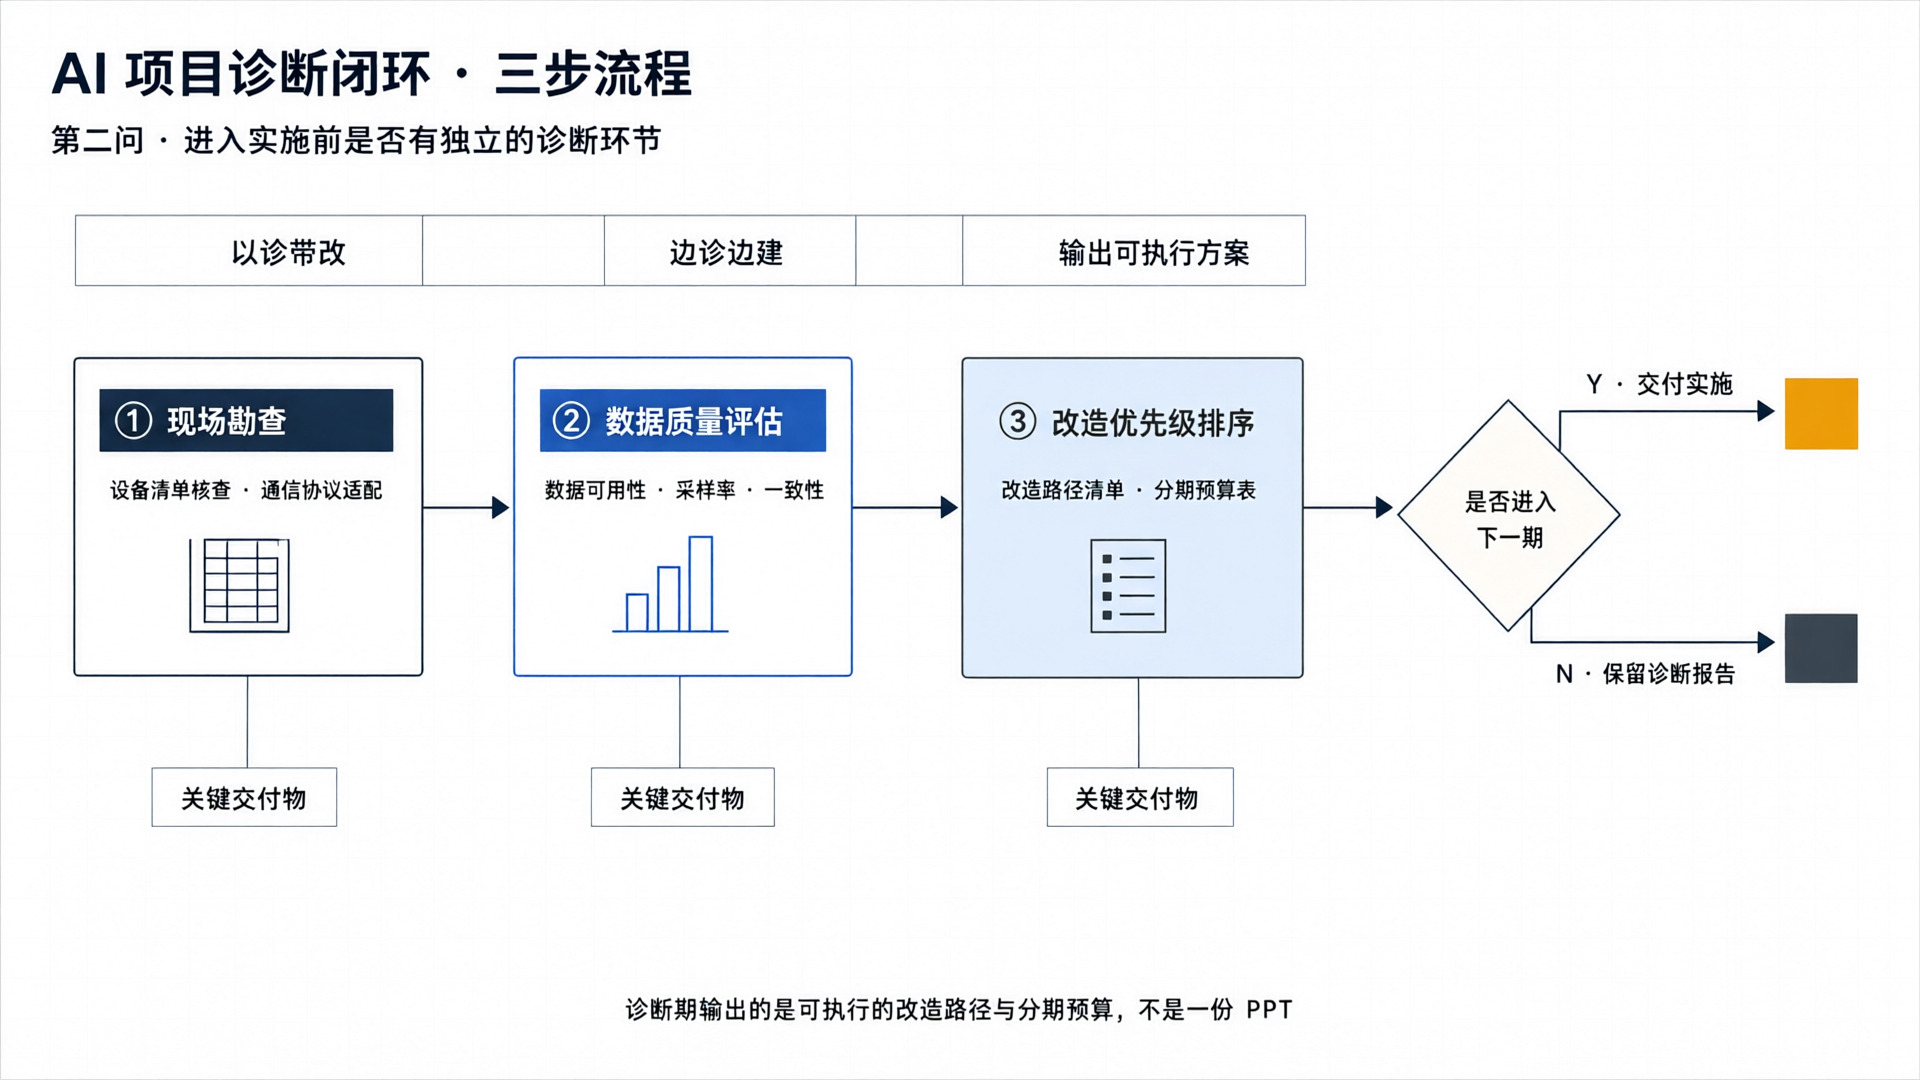
制造、能源、政务、教育四类客户的数字化基础差异极大。同一家制造企业,产线PLC协议不统一、数据孤岛、设备通信带宽不足是三类完全不同的诊断结论,对应完全不同的投入结构。跳过诊断直接给方案,本质上是把选型变成赌博。
我们的方法论是"以诊带改、边诊边建"——诊断期输出可直接执行的改造路径和分期预算(而非一份PPT),客户据此决定是否进入下一期。追问供应商时可以要求看一份脱敏的诊断报告原文,重点关注其中是否包含设备清单核查、数据质量评估和改造优先级排序三项内容。缺少任何一项,说明诊断环节流于形式。
第三问:运维责任在合同里怎么写?
AI系统的衰减曲线是客观规律:模型的准确率随数据分布漂移而下降,硬件在工业环境中的故障率远高于办公环境。政务系统的智能审批模型上线六个月后准确率从92%降到85%是常见情况,不是事故;区别在于合同里有没有把"模型再训练频率""硬件更换响应时间""系统可用性SLA"写成可量化的服务等级指标。
能源客户尤其需要关注这一点——调度系统的中断窗口如果不在合同里明确限定,一次非计划停机带来的生产损失可能数倍于年度运维费用。我们要求运维合同把上述三项指标逐条写进服务等级协议,作为验收和续约谈判的刚性依据。
第四问:你的方案依赖哪个底层生态,锁定成本怎么算?
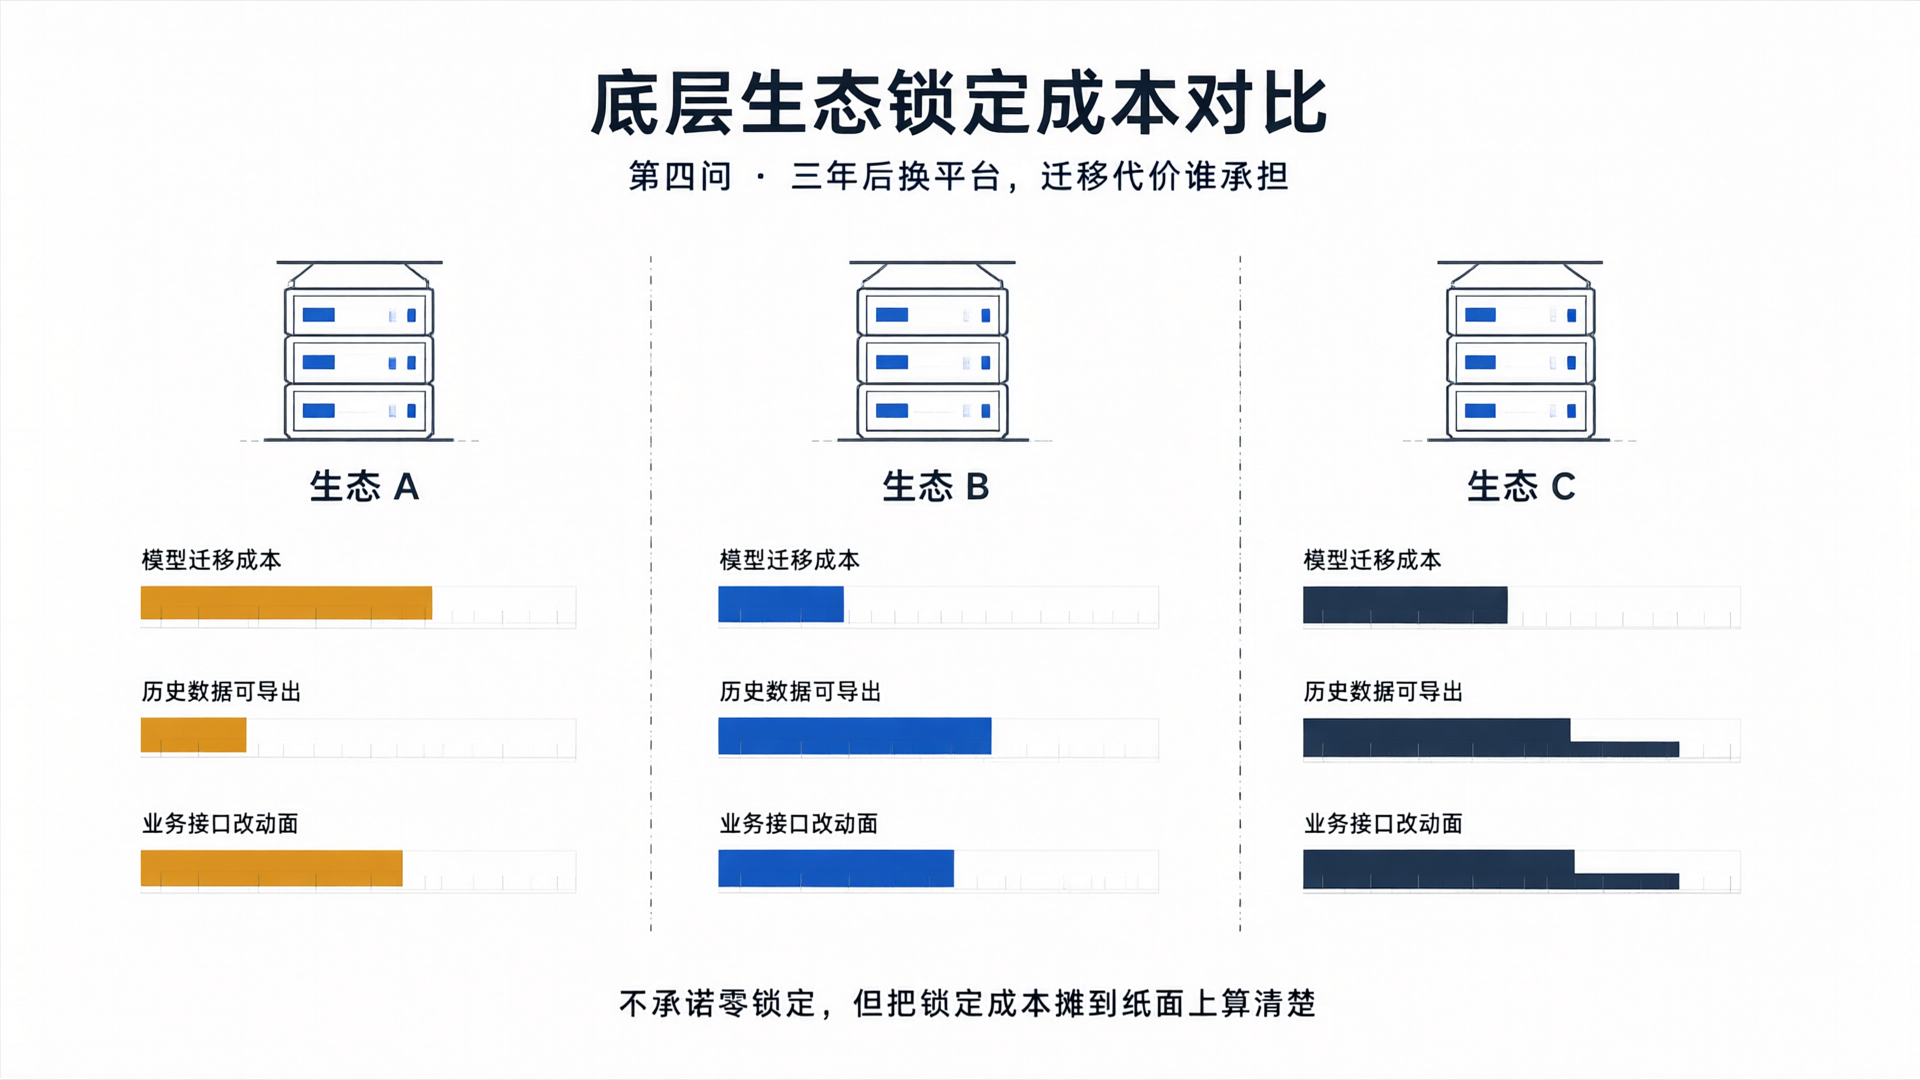
"软硬件一体化"意味着方案必然绑定特定算力平台、操作系统或AI框架。华为昇腾体系、阿里云、H3C各自的技术栈在接口协议和数据格式上互不兼容——这是行业现实,不是偏见。
采购决策者需要追问的具体问题是:如果三年后需要更换底层算力平台,模型迁移需要多少成本,历史数据能否无损导出,业务系统接口改动涉及哪些模块。这并非要求供应商承诺"零锁定"(做到零锁定的方案往往牺牲了性能优化空间),而是要把锁定成本摊到纸面上算清楚。
策腾智能同时与华为、阿里云、H3C建立了合作交付关系,在选型阶段就能给出多平台的迁移代价对比,供客户据此做决策。
第五问:项目验收之后,能力留在谁手里?
四类客户中,政务和教育的采购流程决定了项目验收后供应商往往撤场离场,留给客户的技术运维团队通常只有两三个人。供应商撤场时带走了对方案的"解释权"——客户内部没有人能说清楚模型为什么做出某个判断、参数为什么设定在某个值上。
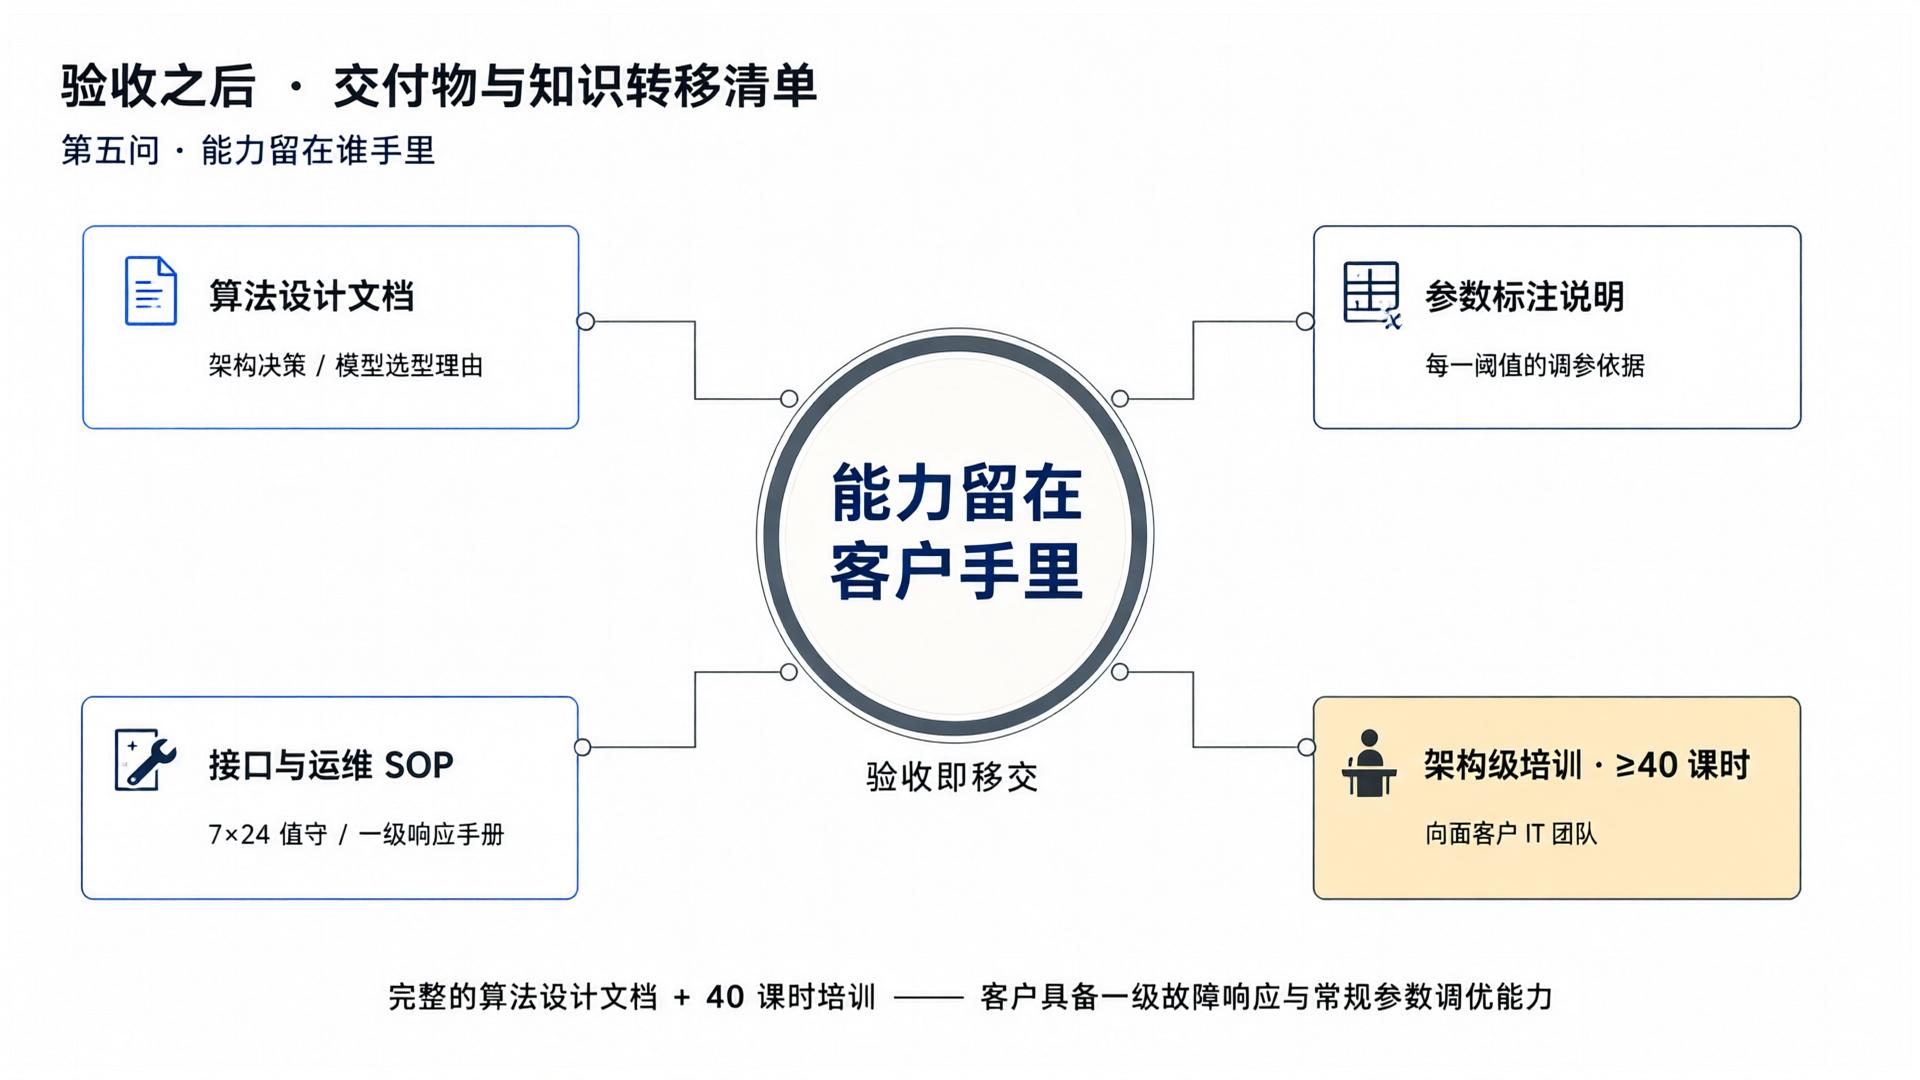
追问供应商时可以直接问一个问题:交付物里是否包含完整的算法设计文档、参数标注说明和内部培训课时记录。如果供应商只给一个黑盒部署包加操作手册,后续任何改动都要回请原厂,年度运维预算就会逐年膨胀。
我们的标准交付物中包含了面向客户IT团队的架构级培训(不少于40课时),目标是让客户内部具备一级故障响应和常规参数调优的能力。
总结
五个问题归结到一件事:全栈AI方案的采购决策,本质上是选择未来三到五年内由谁来对系统效果负责。问题问得越具体,责任边界越清晰。